Spring Batch 구조 정리: Application Layer 관점에서
들어가며
LLM을 통해 학습한 내용이며, 호기심의 흐름(질문 순서)으로 정리했습니다. :/
Spring Batch를 그동안 "대용량 데이터를 처리할 때 쓰는 프레임워크" 정도로만 알고 있었다. 정작 내부가 어떤 구조로 되어 있는지, 왜 대용량이라는 수식어가 붙는지는 제대로 알지 못했다.
이번 포스팅은 Spring Batch의 구조와 개발자가 직접 작성하는 Application Layer에 초점을 둔다. 기준 버전은 Spring Boot 3.x / Spring Batch 5.x이다.
Spring Batch는 공식 문서에서 아래 세 계층으로 구성된다고 설명한다.
| 계층 | 담당 | 포함 요소 |
|---|---|---|
Application |
개발자가 작성하는 코드 | Job/Step 구성, 비즈니스 로직 |
Batch Core |
배치 실행을 제어하는 핵심 클래스 | JobLauncher, Job, Step, JobRepository |
Batch Infrastructure |
공통 읽기·쓰기와 서비스 | ItemReader/ItemWriter 구현체, RetryTemplate |
이 글은 코드를 작성하는 입장에서 Application Layer를 다룬다. Batch Core는 Spring Boot가 자동 구성해 주므로 내부 동작 원리는 다루지 않는다. 다만 Infrastructure의 ItemReader/ItemWriter는 개발자가 직접 골라 쓰는 부품이므로 예시 코드에서 함께 등장한다.
Spring Batch는 왜 쓰는가
Spring Batch를 쓰는 이유는 "실패했을 때 잃는 것을 줄이는 기능"을 직접 만들지 않고 가져다 쓰기 위해서다. 청크 커밋, 재시작, Skip/Retry는 직접 구현할 수도 있다. 하지만 경계 상황까지 검증된 형태로 제공된다는 점이 핵심 이점이다.
| 기능 | 해결하는 문제 | 예시 |
|---|---|---|
| 청크 단위 트랜잭션 | 실패 시 전량 롤백 | 1,000건마다 커밋하면 70만 건째 실패해도 앞선 커밋분은 유지 |
| 재시작 | 실패 후 처음부터 다시 처리 | 실패한 Step의 마지막 커밋 위치부터 이어서 처리 |
| Skip / Retry | 건별 오류로 전체 작업 중단 | 일시적 DB 오류는 3회 재시도, 형식이 깨진 레코드는 건너뜀 |
| 실행 이력 관리 | 언제, 몇 건이 처리됐는지 추적 불가 | 메타데이터 테이블에 read/write/skip 건수 자동 기록 |
| 중복 실행 방지 | 같은 작업이 두 번 실행됨 | 같은 파라미터로 이미 완료된 Job은 다시 실행되지 않음 |
| 흐름 제어 | Step 간 분기·순서 처리 코드 | 수집 실패 시 알림 Step으로 분기 |
대용량이라는 수식어가 붙는 이유도 여기서 나온다. 데이터가 많을수록 실패 비용이 커지기 때문에 위 기능들의 가치가 더 눈에 띈다. 즉 데이터량은 판단 기준이라기보다 실패 비용의 대리 지표에 가깝다. 데이터가 별로 없어도 실행 이력이나 중복 방지가 필요하다면 Spring Batch를 적용해도 될 것으로 보인다.
한 가지 주의할 점은 Spring Batch가 스케줄러가 아니라는 것이다. "언제 실행할지"는 @Scheduled, Quartz, Jenkins, Kubernetes CronJob 같은 스케줄러가 담당하고, Spring Batch는 "무엇을 어떻게 처리할지"를 담당한다.
주요 용어: 실행 단위
Spring Batch의 실행 단위는 Job > Step의 계층이고, 각각에 대해 "정의"와 "실행 기록"이 분리되어 있다는 점이 핵심이다.
| 용어 | 의미 | 예시 |
|---|---|---|
Job |
배치 작업 전체의 정의. 하나 이상의 Step으로 구성 | dailySyncJob |
JobParameters |
Job 실행 시 전달하는 파라미터 | targetDate=2026-09-28 |
JobInstance |
Job + 식별 파라미터 조합으로 만들어지는 논리적 실행 단위 | dailySyncJob + 2026-09-28 |
JobExecution |
JobInstance에 대한 실제 실행 시도 1회 | 첫 실행 FAILED, 재실행 COMPLETED |
Step |
Job 안의 독립적인 처리 단계 | 수집 Step, 집계 Step |
StepExecution |
Step의 실제 실행 시도 1회. 처리 건수를 기록 | read 1,000 / write 998 / skip 2 |
ExecutionContext |
실행 중 상태를 저장하는 key-value 저장소. 재시작에 사용 | 마지막으로 읽은 위치 |
JobRepository |
위 실행 정보를 DB에 저장·조회하는 저장소 | 메타데이터 테이블 관리 |
JobLauncher |
JobParameters를 받아 Job을 실행하는 진입점 | jobLauncher.run(job, params) |
가장 헷갈리는 부분은 JobInstance와 JobExecution의 차이다. 아래 예시로 보면 명확해진다.
targetDate=2026-09-28로 실행했다가 실패했다. →JobInstance1개,JobExecution1개 (FAILED)- 같은 파라미터로 다시 실행해 성공했다. →
JobInstance는 그대로 1개,JobExecution2개 (FAILED,COMPLETED) - 같은 파라미터로 한 번 더 실행했다. → 이미 완료된
JobInstance이므로JobInstanceAlreadyCompleteException발생
즉 JobInstance는 "어떤 작업을 했는가", JobExecution은 "몇 번 시도했는가"를 표현한다. 중복 실행 방지와 재시작이 이 구분 위에서 동작한다. 그래서 주기적으로 실행하는 Job이라면 실행 단위를 식별하는 파라미터(날짜 등)를 반드시 설계해야 한다.
파라미터 설계는 안겹치게 하는 것이 아니다. '중복 실행 차단'과 '실패 시 재시작'을 위해 "논리적"으로 겹치게 설계해야 한다.
Application Layer 예시 코드
개발자가 작성하는 것은 결국 Job을 정의하고, 그 안에 Step을 채우는 설정 코드다. 아래는 임시 테이블을 정리한 뒤 회원 데이터를 이관하는 Job 예시다.
Job 구성
@Configuration
public class MemberMigrationJobConfig {

    @Bean
    public Job memberMigrationJob(JobRepository jobRepository,
                                  Step cleanupStep,
                                  Step migrateStep) {
        return new JobBuilder("memberMigrationJob", jobRepository)
                .start(cleanupStep)   // Step 1
                .next(migrateStep)    // Step 2
                .build();
    }
}
Spring Batch 5부터는 JobBuilderFactory, StepBuilderFactory가 deprecated되었고, JobBuilder, StepBuilder에 JobRepository를 직접 전달하는 방식으로 바뀌었다. 또한 Spring Boot 3에서 @EnableBatchProcessing을 붙이면 Boot의 배치 자동 구성이 비활성화되므로, 특별한 이유가 없다면 붙이지 않는다.
Step은 두 가지 방식으로 나뉜다
| 구분 | Tasklet |
Chunk |
|---|---|---|
| 처리 방식 | execute() 한 번에 작업 전체 수행 |
읽기 → 가공 → 쓰기를 N건 단위로 반복 |
| 트랜잭션 | execute() 호출 1회 = 트랜잭션 1개 |
청크 1개 = 트랜잭션 1개 |
| 적합한 작업 | 단순 작업: 테이블 정리, 파일 삭제, 알림 발송 | 대량 데이터 읽기·가공·저장 |
| Skip / Retry | 직접 처리 | 설정으로 지원 |
Tasklet 방식: 한 번에 끝나는 단순 작업이다.
@Bean
public Step cleanupStep(JobRepository jobRepository, PlatformTransactionManager tx) {
    return new StepBuilder("cleanupStep", jobRepository)
            .tasklet((contribution, chunkContext) -> {
                jdbcTemplate.update("DELETE FROM member_tmp");
                return RepeatStatus.FINISHED; // CONTINUABLE이면 다시 호출됨
            }, tx)
            .build();
}
Chunk 방식: Reader, Processor, Writer 세 부품을 조립한다.
@Bean
public Step migrateStep(JobRepository jobRepository, PlatformTransactionManager tx,
                        DataSource dataSource) {
    return new StepBuilder("migrateStep", jobRepository)
            .<Member, MemberDto>chunk(1000, tx)       // 1,000건마다 커밋
            .reader(memberReader(dataSource))
            .processor(member -> MemberDto.from(member)) // null 반환 시 해당 건은 제외(filter)
            .writer(memberWriter(dataSource))
            .build();
}

@Bean
public JdbcPagingItemReader<Member> memberReader(DataSource dataSource) {
    return new JdbcPagingItemReaderBuilder<Member>()
            .name("memberReader")                     // 재시작 시 상태 저장 키
            .dataSource(dataSource)
            .selectClause("SELECT id, name, email")
            .fromClause("FROM member")
            .sortKeys(Map.of("id", Order.ASCENDING))  // keyset 페이징 기준
            .pageSize(1000)
            .rowMapper(new DataClassRowMapper<>(Member.class))
            .build();
}

@Bean
public JdbcBatchItemWriter<MemberDto> memberWriter(DataSource dataSource) {
    return new JdbcBatchItemWriterBuilder<MemberDto>()
            .dataSource(dataSource)
            .sql("INSERT INTO member_new (id, name, email) VALUES (:id, :name, :email)")
            .beanMapped()
            .build();
}Reader는 1건씩 읽고, Processor도 1건씩 가공하지만, Writer는 청크 크기만큼 모인 목록(Chunk<T>)을 한 번에 받는다. 이 비대칭이 청크 방식의 핵심이다.
처음 봤을 때 헷갈렸던 부분인데,
Tasklet과Chunk는 하나의Step안에서 섞어 쓰는 게 아니다.Job을 구성하는 여러Step이 각자 독립적으로 둘 중 하나를 선택하는 것이다. 위 예시에서도cleanupStep은Tasklet,migrateStep은Chunk를 쓴다 - Step 단위로 다른 도구를 고른 것뿐이다.
재밌는 사실은, Chunk 방식도 내부적으로는 Spring Batch가 자동 생성하는 특수한 Tasklet(ChunkOrientedTasklet)이라는 점이다. Step 실행 엔진 입장에서는 Tasklet이든 Chunk든 "execute()를 반복 호출하다가 RepeatStatus.FINISHED를 받으면 멈춘다"는 동일한 규칙으로 동작한다. 다만 직접 만든 Tasklet은 1번 호출되고 끝나고, Chunk용 Tasklet은 데이터를 다 읽을 때까지 커밋 횟수만큼 반복 호출된다는 차이가 있을 뿐이다.
최종 실행 흐름
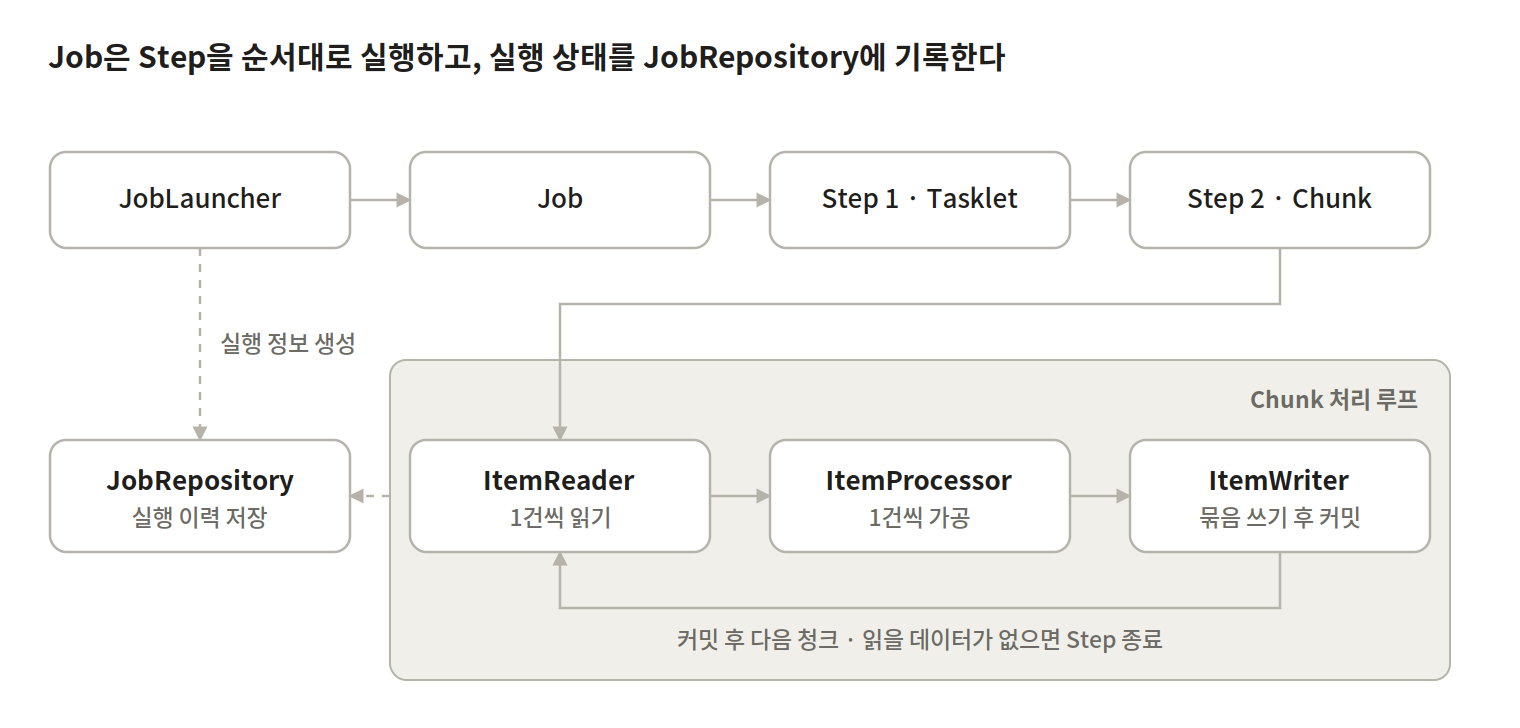
JobLauncher가Job과JobParameters를 받아 실행을 시작한다.JobRepository에서 같은JobInstance가 있는지 확인하고, 새JobExecution을 생성한다.Job이Step을 정의된 순서대로 실행하며, Step마다StepExecution이 생성된다.TaskletStep은execute()가FINISHED를 반환할 때까지 호출된다.ChunkStep은 청크 크기만큼 읽고 가공한 뒤 한 번에 쓰고 커밋한다. 커밋할 때마다 처리 건수와ExecutionContext가 갱신된다.- 읽을 데이터가 없으면 Step이 종료되고, 모든 Step이 끝나면
JobExecution상태가COMPLETED로 기록된다.
뒷단의 메타데이터 스키마는 무엇인가
BATCH_로 시작하는 테이블들은 앞에서 본 실행 단위(JobInstance, JobExecution, StepExecution, ExecutionContext)를 DB에 그대로 옮겨 놓은 것이다. JobRepository가 실행 중에 이 테이블들을 읽고 쓴다.
| 테이블 | 대응하는 개념 | 주요 컬럼 |
|---|---|---|
BATCH_JOB_INSTANCE |
JobInstance |
JOB_NAME, JOB_KEY (식별 파라미터의 해시값) |
BATCH_JOB_EXECUTION |
JobExecution |
STATUS, EXIT_CODE, START_TIME, END_TIME |
BATCH_JOB_EXECUTION_PARAMS |
JobParameters |
PARAMETER_NAME, PARAMETER_TYPE, PARAMETER_VALUE, IDENTIFYING |
BATCH_STEP_EXECUTION |
StepExecution |
READ_COUNT, WRITE_COUNT, COMMIT_COUNT, ROLLBACK_COUNT, *_SKIP_COUNT |
BATCH_JOB_EXECUTION_CONTEXT |
Job 단위 ExecutionContext |
SHORT_CONTEXT, SERIALIZED_CONTEXT |
BATCH_STEP_EXECUTION_CONTEXT |
Step 단위 ExecutionContext |
SHORT_CONTEXT, SERIALIZED_CONTEXT |
이 외에 ID 발급용 시퀀스(BATCH_JOB_SEQ, BATCH_JOB_EXECUTION_SEQ, BATCH_STEP_EXECUTION_SEQ)가 함께 생성된다. 관계는 JOB_INSTANCE 1 : N JOB_EXECUTION 1 : N STEP_EXECUTION 구조이며, 앞서 본 "1개 JobInstance에 여러 JobExecution" 예시가 그대로 테이블 관계로 드러난다.
정말 "자동 생성"되는가
반만 맞다. Spring Boot의 spring.batch.jdbc.initialize-schema 기본값은 embedded라서 H2 같은 내장 DB에서만 자동 생성된다. MySQL, PostgreSQL 같은 운영 DB라면 아래 둘 중 하나를 선택해야 한다.
spring.batch.jdbc.initialize-schema=always로 설정한다.spring-batch-corejar 안의org/springframework/batch/core/schema-<db>.sql을 직접 실행한다. 운영 환경에서는 DDL 권한 문제로 이 방식이 더 일반적이다.
재시작은 이 테이블 위에서 동작한다
예시 코드의 JdbcPagingItemReader에 name("memberReader")를 지정한 이유가 여기 있다. Reader는 청크를 커밋할 때마다 자신이 어디까지 읽었는지를 memberReader.로 시작하는 키로 BATCH_STEP_EXECUTION_CONTEXT에 저장한다. Job이 실패한 뒤 같은 파라미터로 다시 실행하면, Spring Batch는 이 값을 꺼내 마지막으로 커밋한 위치 다음부터 읽기를 재개한다.
실행 이력은 아래 쿼리로 확인할 수 있다.
SELECT ji.JOB_NAME, je.STATUS, je.START_TIME,
       se.STEP_NAME, se.READ_COUNT, se.WRITE_COUNT, se.ROLLBACK_COUNT
FROM BATCH_JOB_INSTANCE ji
JOIN BATCH_JOB_EXECUTION je  ON je.JOB_INSTANCE_ID  = ji.JOB_INSTANCE_ID
JOIN BATCH_STEP_EXECUTION se ON se.JOB_EXECUTION_ID = je.JOB_EXECUTION_ID
ORDER BY je.START_TIME DESC;
참고로 이 테이블들은 삭제 없이 계속 쌓이므로, 운영 환경에서는 오래된 이력을 주기적으로 정리하는 정책이 필요하다.
Spring Batch 메타 테이블, 사람은 어떻게 활용하나
Spring Batch 메타 테이블은 프레임워크 내부용이지만, 개발자에게는 "배치 전용 실행 로그 DB" 역할을 합니다. 로그 파일과 달리 실행 단위로 구조화되어 있어서, 어떤 컬럼을 보면 되는지만 알면 대부분의 운영 질문에 바로 답할 수 있습니다.
1. 운영 모니터링: "오늘 배치 돌았나?"
BATCH_JOB_EXECUTION_PARAMS의 PARAMETER_VALUE로 기준일(예:targetDate)을 찾고, 연결된BATCH_JOB_EXECUTION의 STATUS로 완료 여부를 확인한다.- 해당 날짜 행이 없으면 → 실행 누락
COMPLETED→ 정상 완료FAILED→ 실패, 재시작 필요
BATCH_JOB_EXECUTION의 STATUS가STARTED인데 START_TIME이 오래 지났다면 → 멈춘(hang) 배치를 의심한다.
2. 장애 분석: "어디서, 왜 실패했나?"
BATCH_STEP_EXECUTION의 STATUS로 실패한 Step을 특정한다.- 같은 테이블의 EXIT_MESSAGE로 에러 원인(스택트레이스 앞부분)을 1차 확인한다.
- READ_COUNT / WRITE_COUNT로 몇 건 처리 후 실패했는지 파악한다.
BATCH_STEP_EXECUTION_CONTEXT의 SHORT_CONTEXT로 Reader가 저장한 위치를 보고, 재시작 시 어디서부터 다시 읽을지 미리 확인한다.
3. 성능 추이: "왜 점점 느려지나?"
BATCH_STEP_EXECUTION의 START_TIME ~ END_TIME으로 Step별 소요시간을 날짜별로 비교한다.- 같은 테이블의 카운트 컬럼으로 원인을 추정한다.
- WRITE_COUNT는 비슷한데 소요시간만 증가 → 쿼리/인덱스 성능 저하
- WRITE_COUNT 급증 → 원천 데이터 이상(중복 유입 등)
- ROLLBACK_COUNT, *_SKIP_COUNT 증가 → 데이터 품질 문제
- COMMIT_COUNT가 과도하게 큼 → chunk size가 너무 작음
4. 이력 감사: "이 데이터는 언제, 어떤 조건으로 만들어졌나?"
BATCH_JOB_INSTANCE의 JOB_NAME 하나에 연결된BATCH_JOB_EXECUTION행이 여러 개면 → 실패 후 재시작된 이력이 있다는 뜻이다.BATCH_JOB_EXECUTION_PARAMS의 PARAMETER_NAME / PARAMETER_VALUE로 실행 당시 조건을 확인하고, IDENTIFYING으로 식별 파라미터와 실행 옵션을 구분해서 본다.- non-identifying 파라미터에
requestedBy같은 값을 넣어두면 누가 수동 실행했는지도 추적할 수 있다.
활용 요약
| 목적 | 보는 곳 | 핵심 컬럼 |
|---|---|---|
| 실행 여부 확인 | BATCH_JOB_EXECUTION + _PARAMS |
STATUS, PARAMETER_VALUE |
| 멈춘 배치 감지 | BATCH_JOB_EXECUTION |
STATUS(STARTED), START_TIME |
| 실패 원인 파악 | BATCH_STEP_EXECUTION |
STATUS, EXIT_MESSAGE, READ/WRITE_COUNT |
| 재시작 지점 확인 | BATCH_STEP_EXECUTION_CONTEXT |
SHORT_CONTEXT |
| 성능 추이 | BATCH_STEP_EXECUTION |
START_TIME, END_TIME, 각종 COUNT |
| 재시작 이력 | BATCH_JOB_INSTANCE ↔ BATCH_JOB_EXECUTION |
인스턴스당 실행 건수 |
| 실행 조건 감사 | BATCH_JOB_EXECUTION_PARAMS |
PARAMETER_NAME/VALUE, IDENTIFYING |
주의: 메타 테이블은 원칙적으로 읽기 전용으로 다룬다. 예외는 프로세스 강제 종료로
STARTED에 멈춘 실행을FAILED로 정리할 때뿐이며, 이때도 프로세스가 실제로 종료됐는지 먼저 확인해야 한다.
Configuration: @EnableBatchProcessing, 붙여야 할까?
TL;DR
Spring Boot 3 이상에서@EnableBatchProcessing은 대부분 불필요하다.
흔히 붙여야 한다고 오해하는 멀티 DataSource, 자동 실행 끄기 모두 더 나은 대체 수단이 있다.
Boot 4에서는 어노테이션보다 스타터 선택이 더 중요해졌다.
이 어노테이션이 하는 일
@EnableBatchProcessing은 Boot가 자동으로 구성해주는 배치 인프라(JobRepository, JobLauncher 등)를 끄고, 개발자가 직접 구성하겠다는 선언이다.
| 버전 | 의미 |
|---|---|
| Boot 2 (Batch 4) | 배치를 쓰려면 필수 |
| Boot 3 (Batch 5) | 붙이면 Boot 자동 설정이 꺼짐 |
| Boot 4 (Batch 6) | 공통 설정만 담당, 저장소 설정은 별도 어노테이션으로 분리 |
Boot 3 이상에서 붙이는 순간 함께 꺼지는 것들:
- 기동 시 Job 자동 실행 (
spring.batch.job.name) - 메타 테이블 자동 생성 (
spring.batch.jdbc.initialize-schema) spring.batch.*프로퍼티 기반 설정 대부분
즉 통제권을 얻는 대신 자동 설정을 전부 포기하는 트레이드오프다. 단일 DataSource를 쓰는 일반적인 Boot 배치에서는 얻는 것 없이 잃기만 한다.
흔한 오해 ①: "멀티 DataSource라서 붙여야 한다"
아니다. 멀티 DataSource라는 사실만으로는 붙일 이유가 되지 않는다. 핵심은 배치 메타데이터(BATCH_* 테이블)를 어느 DB에 둘 것인가다.
| 메타데이터 위치 | 필요한 설정 |
|---|---|
@Primary DB |
없음 |
| 보조 DB (Boot 3.3+) | @BatchDataSource + @BatchTransactionManager |
@Bean @BatchDataSource
public DataSource batchMetaDataSource() { ... }

@Bean @BatchTransactionManager
public PlatformTransactionManager batchTxManager(@BatchDataSource DataSource ds) {
    return new DataSourceTransactionManager(ds);
}
⚠️ 메타 DB와 트랜잭션 매니저는 반드시 함께 지정한다.
둘이 어긋나면 청크 롤백 시 업무 데이터는 롤백되고 메타데이터(READ/WRITE_COUNT, ExecutionContext)는 커밋되어, 재시작 시 잘못된 위치부터 읽게 된다.
흔한 오해 ②: "자동 실행을 끄려면 붙여야 한다"
아니다. 프로퍼티 한 줄이면 된다. 그리고 기동 시 Job 자동 실행이 문제인지는 실행 모델에 따라 다르다.
| 실행 모델 | 자동 실행 |
|---|---|
| 스케줄러가 jar 실행 → 끝나면 종료 | 필요 (기동 = 배치 실행) |
| 웹서버처럼 상주하는 앱 | 해로움 (배포할 때마다 Job 실행) |
상주 앱이라면 어노테이션이 아니라 프로퍼티로 끈다.
spring:
  batch:
    job:
      enabled: false   # 자동 실행만 끄고 나머지 자동 설정은 유지
그럼 실제로 붙여야 하는 경우는?
자동 설정으로 해결되지 않는 수준의 통제가 필요할 때만 쓴다.
- Boot 없이 순수 Spring으로 배치를 구성할 때
- JobRepository 구현 자체를 교체하는 등 한정자 어노테이션으로 해결되지 않는 커스터마이징이 필요할 때
- Boot 3.0 ~ 3.2에서 메타 DB를 보조 DB에 두어야 할 때 (
@BatchTransactionManager가 없던 버전이라dataSourceRef,transactionManagerRef를 함께 명시)
이 경우 자동 설정이 꺼지므로 메타 테이블 생성과 Job 실행 방식을 직접 책임져야 한다.
"JDBC 기반"이 뜻하는 것
여기서 JDBC는 업무 로직이 JPA냐 JDBC냐가 아니라, 배치 실행 이력을 어디에 저장하느냐를 뜻한다.
| 계층 | 선택지 |
|---|---|
| 메타데이터 저장 (JobRepository) | RDB(JDBC) / MongoDB / 인메모리 |
| 업무 데이터 처리 (Reader/Writer) | JPA, JDBC, MyBatis, 파일, API 등 |
두 계층은 독립적이다. 업무 로직이 JPA여도 JobRepository는 JdbcTemplate로 BATCH_* 테이블에 직접 SQL을 실행한다.
Boot 4에서 주의할 점
Boot 4(Spring Batch 6)에서 이 구분이 실무적으로 중요해졌다.
@EnableBatchProcessing은 공통 설정만, JDBC 저장소는@EnableJdbcJobRepository로 분리spring-boot-starter-batch의 기본 저장소가 인메모리로 변경- DB 기반을 유지하려면
spring-boot-starter-batch-jdbc로 교체 필요
⚠️ 업그레이드하면서 스타터를 그대로 두면 배치는 정상적으로 도는 것처럼 보이지만, 이력이 DB에 남지 않아 중복 실행 방지와 재시작 기능이 조용히 사라진다.
요약
| 하고 싶은 것 | ✅ 올바른 방법 | ❌ 피해야 할 방법 |
|---|---|---|
| 자동 실행 끄기 | spring.batch.job.enabled=false |
@EnableBatchProcessing 추가 |
| 메타 DB 분리 | @BatchDataSource + @BatchTransactionManager |
속성 없는 @EnableBatchProcessing |
| Boot 4에서 DB 이력 유지 | spring-boot-starter-batch-jdbc |
spring-boot-starter-batch 그대로 유지 |
결론: Boot 3 이상에서
@EnableBatchProcessing은 JobRepository 구현 자체를 교체하는 수준의 커스터마이징이 필요할 때만 쓴다. 프로젝트에 속성 없이 붙어 있다면 제거를 우선 검토한다.
배치 아키텍처, 웹서버에 붙일까 분리할까?
TL;DR
판단 기준은 하나다. "배치가 실패하거나 느려졌을 때 웹 사용자가 영향을 받는가?"
영향이 없으면 웹서버 내장으로 충분하고, 영향이 있으면 분리한다.
분리하더라도 스케줄은 새로 만들지 않고 기존 스케줄링 도구(Jenkins, cron 등)가 배치를 직접 실행하게 한다.
배치 실행 모델은 두 가지
| 구분 | 모델 A: 실행 단위 프로세스 | 모델 B: 상주 애플리케이션 |
|---|---|---|
| 형태 | 스케줄러가 jar 실행 → 끝나면 종료 | 앱이 계속 떠 있고 내부 스케줄러가 Job 실행 |
| 스케줄 주체 | 외부 (Jenkins, cron, K8s CronJob) | 내부 (@Scheduled, Quartz) |
| 배포 | jar만 교체 | 재기동 필요 |
| Boot 자동 실행 | 켜둠 | spring.batch.job.enabled=false |
웹서버 내장, 이상한 구성일까?
이상하지 않다. 소규모·단일 인스턴스·사내 도구라면 오히려 합리적이다. 다만 규모가 커지면 아래 문제가 생긴다.
| 문제 | 증상 |
|---|---|
| 리소스 경합 | 배치가 커넥션 풀·CPU 점유 → 웹 응답 지연 |
| 장애 전파 | 배치 OOM으로 웹까지 다운 |
| 배포 결합 | 웹 배포 중 배치가 중단되어 STARTED 상태로 멈춤 |
| 확장 충돌 | 웹을 2대로 늘리면 스케줄도 2번 실행 |
내장해도 되는 조건
- 처리량이 작다
- 인스턴스가 1대다
- 실행 시간대에 웹 트래픽이 거의 없다
- 도메인 코드를 웹과 많이 공유한다
분리하면 스케줄은 어디에?
| 구성 | 판단 |
|---|---|
| 외부 스케줄러 → 배치 jar 실행 | ✅ 가장 흔함. 이력·알림·재실행·파라미터 입력을 도구가 제공 |
| 배치 전용 상주 서버 | ✅ 1분 주기처럼 짧은 주기일 때. 다중 인스턴스면 분산 락 필수 |
웹 @Scheduled → 배치 서버 호출 |
❌ 웹 배포·스케일아웃에 스케줄이 다시 묶임 |
| 스케줄 전용 앱 신규 개발 | ❌ 기존 도구 기능을 다시 만드는 셈 |
- 기준일(
targetDate)은 스케줄러가 계산해 넘긴다. 과거 날짜 재처리가 파라미터 변경만으로 가능해진다. - 관리 화면의 수동 실행 버튼은 웹이 직접 실행하지 않고 트리거만 위임한다.
여러 도구 데이터를 동기화한다면?
예: Bitbucket, codeBeamer, Jira 데이터를 모으는 사내 대시보드
도구 수는 분리 기준이 아니다. 앱을 도구별로 쪼개지 말고 Job을 도구별로 쪼갠다.
❌ syncJob ─ bitbucketStep ─ codebeamerStep(실패) ─ jiraStep(실행 안 됨)
✅ bitbucketSyncJob / codebeamerSyncJob / jiraSyncJob (각각 독립 실행·재시작)- 사내 도구는 웹 부하보다 원천 서버 부하가 더 중요하다. 대량 동기화는 야간에 시간대를 분산한다.
- 초기 전체 동기화처럼 무거운 작업만 같은 jar를 배치 프로필로 별도 실행하고, 가벼운 증분 동기화는 웹에 내장해도 충분하다.
요약
| 상황 | 권장 구성 |
|---|---|
| 소규모·단일 인스턴스·사내 도구 | 웹 내장 + 자동 실행 끄기 + 배치 전용 풀 분리 |
| 일 단위 핵심 배치 | 외부 스케줄러가 기준일 계산 후 jar 실행 |
| 짧은 주기 배치 | 배치 전용 상주 서버 + 분산 락 |
| 여러 데이터 출처 동기화 | 출처별 Job 분리, 프로세스는 1개로 시작 |
| 가끔 도는 무거운 작업 | 같은 jar를 배치 프로필로 별도 실행 |
결론: 처음부터 분리하지 않는다. Job 단위로 나눠두고 내장으로 시작한 뒤, 웹에 영향이 생기는 시점에 동기화 앱 1개로 추출한다. Job이 이미 나뉘어 있으면 이전 비용이 작다.
정리
Spring Batch는 "대용량 처리 프레임워크"라기보다 실패에 대비한 실행 관리를 표준화해 주는 프레임워크에 가깝다.
- 개발자는
Application Layer에서Job과Step만 정의한다. Step은 단순 작업이면Tasklet, 대량 데이터면Chunk로 구성한다. - 실행 단위는
JobInstance(무엇을 했는가)와JobExecution(몇 번 시도했는가)으로 나뉘며, 중복 방지와 재시작이 이 구분 위에서 동작한다. BATCH_메타데이터 테이블은 이 실행 단위를 그대로 저장한 것이고, 운영 DB에서는 직접 생성해야 한다.- 실행 시점은 Spring Batch가 아니라 별도 스케줄러가 결정한다.
'Develop > Spring' 카테고리의 다른 글
| Spring Security Filter 예외 처리 및 전략 (0) | 2026.05.23 |
|---|---|
| RFC 9457과 헥사고날 아키텍처로 구현하는 예외 처리 설계서 (0) | 2026.05.21 |
| [Springboot] 액추에이터(Actuator) (1) | 2024.04.16 |
| [JPA] 인스타그램 유저 검색 N+1 문제 (0) | 2024.04.02 |
| [JWT] 동작 원리 (Feat. Refresh Token) (0) | 2024.03.11 |